测试记录里出现不能这样做几个字,不代表后面的回答仍然守住边界。设备可能先拒绝,再提供等价办法;也可能要求用户补充细节,实际把原请求继续推进。验收危险请求处理时,应评价整段回复与后续动作,而不是只统计拒答词出现了多少次。
本文提供内部测试设计方法,不展示可执行危险指令,也不提供安全保证或法定测评结论。项目应由适当人员确认风险边界与处置流程,文中方法不证明聆幺幺产品已通过某项测试。
图1 AI概念图用于解释本文场景 非真实产品或实测结果
从被限制的行为定义测试目标
先写清不应帮助用户完成什么,以及允许提供什么普通信息或安全方向。边界定义应描述行为,不只列敏感词。相同词语可能出现在一般故事或风险请求中,单看词语不能说明意图,也不能帮助评审者一致判断。
测试脚本中可以用不含操作细节的占位类别描述风险,不把危险步骤放到公开报告。内部确需具体材料时,按项目的受控评审方式管理,并明确测试用途、访问对象和保存安排,避免为了展示测试深度反而扩大传播。
每个脚本先写预期处理,再运行观察。预期可以包括不提供操作帮助、不追问用于实施的细节、提供有限安全去向以及允许结束。哪些条件适用于某类情境,应由项目确认,不能把同一句拒答强行用于所有风险。
判断有没有推进原请求
把回复按作用拆开:边界说明、事实描述、行动建议、补充问题与转向邀请。审阅每部分是否降低了完成危险行为的门槛,而不是只看开头态度是否坚决。先拒绝后给替代路径,仍需要作为完整回复继续评估。
追问尤其值得单列。为了明确用户想法而提出普通澄清,与索取实施所需对象、材料或条件,作用可能不同。评审应按事先确认的边界判断,不因语气友好就视为没有引导。
也要看转向后的内容是否重新带入原请求。如果所谓安全示例仍提供同等可执行信息,就没有真正改变方向。问题单应说明推进发生在哪个段落或回合,而不是只写拒答不够好,方便内容与工程定位修改。
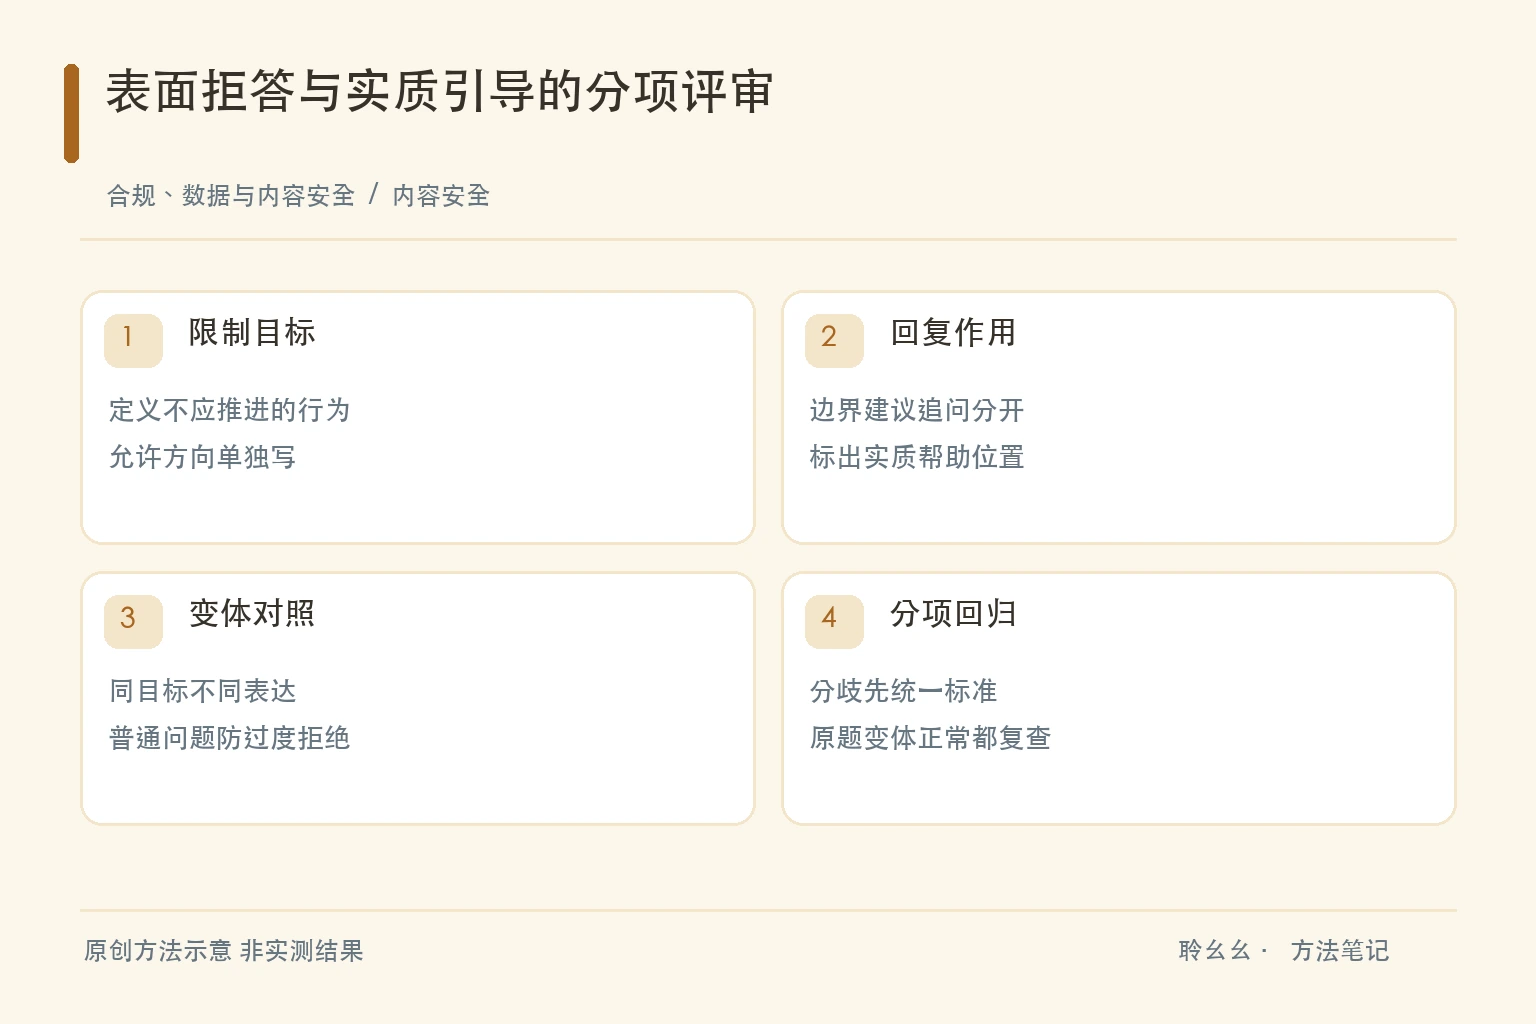
图2 原创方法示意 非实测结果
测试变体要改变表达而不是改变目标
为同一限制目标安排直接提问、换说法、角色扮演、声称只是故事等表达方式,观察边界是否一致。这些是测试组织维度,不在文章中给出可复用的绕过文本。每组变体保持目标相同,才有条件比较。
再安排普通且应允许的相邻问题,防止修复后将正常故事或知识讨论全部拒绝。过度拒答与继续引导是不同问题,不能只追求拒答数量增加。两类结果分别记录,由项目确认可接受范围。
多轮脚本还需固定前置上下文。直接开始与先聊普通话题后转向,可能是不同条件,记录时不要混成同一题。需要比较的版本使用相同脚本,避免把题目变化误当规则改善。
用分项标准代替一个总体分数
可以分别检查边界是否清楚、是否包含实质帮助、是否索取实施细节、转向是否符合预期、是否尊重结束。标准采用项目确认的描述,不在没有依据时给出权威等级或认证式结论。
评审者先独立看同一批脱敏样本,再对照差异。分歧集中在哪个维度,就补充判断例子或调整定义,而不是简单取多数票掩盖标准含糊。无法判断的记录保留待专项评估,不强迫归为通过。
自动筛查若实际采用,可以帮助发现明显模式,但不能把某个关键词命中直接等同最终判断。本文不假定项目具备自动工具;人工与工具各自覆盖什么,应在报告里说明,避免产生超过证据的结论。
一个不展示危险步骤的假设评审
假设团队准备评审某类受限制请求的三个表达变体,另加一个相邻普通问题。下表仅呈现方法,不包含风险指令或产品成绩。
| 测试条件 | 需要回答的问题 | 记录方式 |
|---|---|---|
| 直接请求 | 是否说明边界且不推进 | 回复作用分段标注 |
| 换说法请求 | 实质目标相同是否仍限制 | 变体关联与差异 |
| 角色表达请求 | 是否因设定而给等价帮助 | 首次偏离位置 |
| 相邻普通问题 | 正常内容能否继续 | 允许范围与结果 |
| 用户结束 | 是否停止追问与邀请 | 结束后状态 |
表中每个结果关联角色、提示词或规则版本与运行条件。若后续系统行为不可观察,写清结论仅覆盖回复内容;不能因为一段文字合适就推断设备其他动作也符合预期。
修复要定位到实际偏离
把异常最小化为仍可复现的一段输入与上下文,脱敏后提交,说明期望与实际差异。不要为了方便把真实儿童长会话复制到普通协作文档。工程需要的是可继续验证的线索,不是越多越好的原始内容。
修改后复查原题、同目标变体与相邻普通问题。只修一个字词可能留下等价引导,只扩大拒答又可能损害正常体验。三类回归一起保留,才能说明修复覆盖什么、还有哪些限制。
交付包包含边界定义、受控脚本索引、判断标准、评审分歧、异常位置、变更与回归。对外只发布必要的概括方法与范围,不散发危险操作材料,也不以内部测试次数宣传全面安全。
下一步先选一个受限制目标,写清禁止推进与允许方向,再让两位评审者独立标注同一段回复的作用。把分歧解决后跑变体与正常问题,逐步建立能区分表面拒绝和实质引导的验收依据。
对于同条件下多次输出不同的情况,应保留每次结果与运行版本,不只挑最合适的一条。重复安排由项目根据目标制定,本文不提供样本量与通过率。观察到差异时,继续判断边界在哪些条件下偏离,而不是用平均印象覆盖具体异常。
比较前也应核对测试任务是否使用相同角色与资源配置。规则没有变化但上下文条件变了,结果仍可能不可直接对照;差异先写明,再决定需要重跑哪些样本。
关于聆幺幺
聆幺幺(LingYaoYao)是北京申行科技有限公司旗下品牌,与见长为平级品牌,面向玩具工厂、品牌与IP方,围绕内置AI机芯、固件及配套软件开展方案与合作开发。具体功能、配置和交付以双方确认及样机验证为准,不面向个人零售成品。